

Ein Kunde meldet einen Fehler, der bis Feierabend behoben sein soll. Der Fix selbst ist in fünf Minuten geschrieben. Der unsichere Teil kommt danach: Wurde wirklich die richtige Datei hochgeladen? Läuft die Seite noch, oder ist irgendwo eine Konfiguration überschrieben worden? Laufen noch alle notwendigen Features? Bei uns lief das früher oft über FTP, manuell, mit genau dem Fehlerrisiko, das man an dieser Stelle am wenigsten brauchen kann.
Nicht das Hochladen selbst ist das Problem. Das Problem ist, es unter wechselnden Bedingungen zuverlässig zu wiederholen. Genau dafür gibt es Deployment-Pipelines: eine Abfolge automatisierter Schritte, die Code testet, baut und kontrolliert auf eine Zielumgebung bringt, von der ersten Code-Änderung bis zur freigegebenen Veröffentlichung.
Was ist eine Deployment-Pipeline?
Eine Deployment-Pipeline ist eine Abfolge automatisierter und kontrollierter Schritte. Jede Code-Änderung durchläuft dieselben Tests, wird auf dieselbe Art gebaut und landet über denselben Weg auf dem Server. Sie ersetzt keine menschlichen Entscheidungen wie eine Freigabe vor dem Go-Live. Automatisiert wird nur, was sowieso bei jedem Release gleich ablaufen sollte: Tests ausführen, Code bauen und die Dateien an den richtigen Ort bringen.
Ein bekanntes Bild dafür ist die Qualitätskontrolle am Förderband statt eines einzelnen, manuellen Umzugs. Jedes Teil durchläuft dieselbe Kontrolle, in derselben Reihenfolge, bevor es weitergeht.
Drei Begriffe kurz erklärt
CI/CD wird oft wie ein einziger Begriff verwendet, deckt aber drei unterschiedlich weit gehende Stufen ab.
- Continuous Integration (CI)
Änderungen werden häufig zusammengeführt und automatisch geprüft.
Praxisnutzen: Fehler fallen früh auf, nicht erst kurz vor dem Release.
- Continuous Delivery
Nach erfolgreichen Prüfungen ist eine Version jederzeit bereit für die Veröffentlichung.
Praxisnutzen: Der Release bleibt eine bewusste, manuelle Entscheidung.
- Continuous Deployment
Jede erfolgreich geprüfte Änderung wird automatisch produktiv geschaltet.
Praxisnutzen: Sehr kurze Lieferzeit, braucht aber hohe Testabdeckung.
Bei vielen unserer Projekte setzen wir auf Continuous Delivery. Tests und Build laufen bei jedem Push automatisch, das Deployment selbst bleibt an den main-Branch gebunden. Volles Continuous Deployment, bei dem jede geprüfte Änderung ohne weiteren Klick live geht, lohnt sich vor allem bei sehr hoher Testabdeckung und Projekten mit vielen kleinen, risikoarmen Änderungen.
So sieht eine typische Pipeline aus
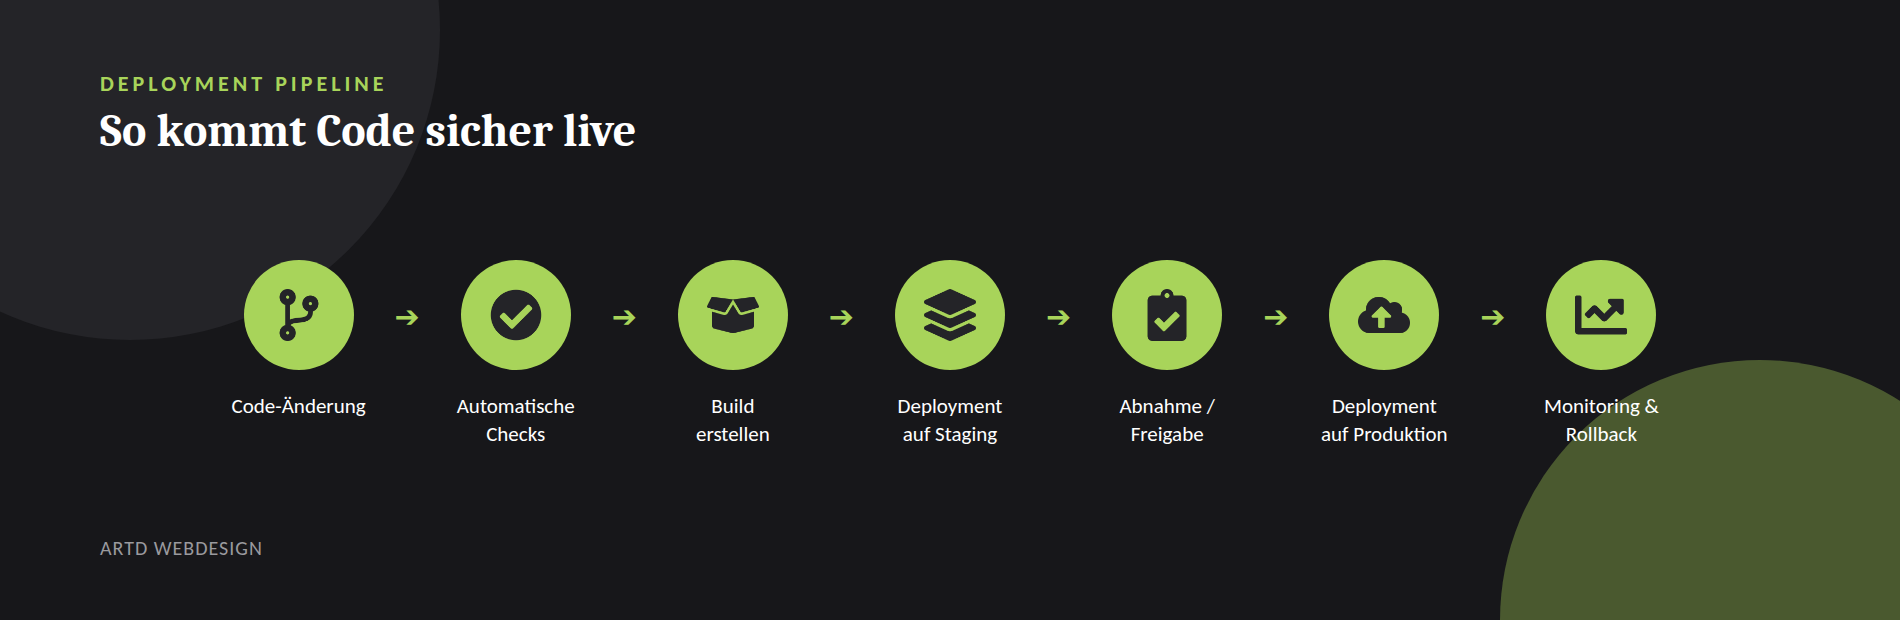
Code-Änderung und Versionskontrolle
Änderungen laufen über Git, meist per Pull Request. Für die Branching-Strategie reicht in den meisten unserer Projekte ein einfaches main plus feature/-Branches. Komplexere Modelle lohnen sich erst bei grösseren Teams mit mehreren parallelen Releases.
Automatische Tests
Bei jedem Push und jedem Pull Request laufen bei uns PHP-Tests und der Frontend-Build parallel: composer validate --strict und php artisan test auf der einen Seite, npm ci und npm run build auf der anderen. Auf einem Pull Request endet die Pipeline nach diesem Schritt. Erst auf main geht es weiter zum Deployment.
Build-Artefakt erstellen
Das Artefakt wird einmal gebaut und wandert unverändert durch die Umgebungen. Bei unseren Statamic-Projekten heisst das: Composer installiert die PHP-Abhängigkeiten ohne Dev-Pakete, npm baut die Frontend-Assets, und genau dieses Ergebnis wird später aktiviert statt ein zweites Mal gebaut. Der Server bekommt nie Build-Werkzeuge, nur fertige Dateien.
Staging und Abnahme
Eine feste Staging-Umgebung für Releases kommt bei uns bei ausgewählten Projekten zum Einsatz. Aktuell prüfen wir Änderungen grösstenteils lokal und danach auf der Staging-Umgebung über den PR-Diff, bei kritischeren Projekten zusätzlich manuell vor dem Release.
Go-Live auf Production
Der Server aktiviert nur geprüfte Artefakte, nie eigenen Code. Bei Statamic läuft das über ein eigenes Git-Repository direkt im Web-Root des Servers: Die Pipeline baut das Artefakt per rsync auf ein Staging-Verzeichnis, ein Aktivierungsskript auf dem Server übernimmt es danach. Gleichzeitig wird der Quellcode via Git-Pull auf den Server geladen, ebenfalls getriggert durch die Pipeline. Im Anschluss werden die jeweiligen Caches geleert. Voraussetzung ist ein Hostinganbieter mit Git und SSH-Zugang.
Praxisbeispiel: Unsere eigene Bitbucket Pipeline
So sieht das bei uns in einem laufenden Statamic-Projekt aus, aufgeteilt in vier eigenständige Pipelines:
- Qualitätsprüfung (PR & main): Tests und Build bei jedem Push, ohne Deployment.
- Deployment (nur main): Artefakte bauen und den Server aktivieren.
- Dependency-Update (wöchentlich): Abhängigkeiten aktualisieren, Pull Request öffnen.
- Security Audit (täglich):
composer auditundnpm audit, bei einem kritischen Fund startet automatisch die Dependency-Update-Pipeline.
Vier klar getrennte Aufgaben statt einer grossen Pipeline, die alles auf einmal macht. Das hält jede einzelne überschaubar und macht Fehler leichter lokalisierbar.
Zum Aufwand gehört auch das Budget: Unser Bitbucket-Plan beinhaltet 2’500 Build-Minuten pro Monat, zusätzliche Minuten kosten 10 USD pro 1’000 Minuten. Für die meisten Projekte dieser Grösse reicht das gut aus, es lohnt sich aber, das im Blick zu behalten, sobald mehrere Pipelines täglich laufen.
Häufige Bedenken, und was daran stimmt
„Das ist nur etwas für grosse Teams.“
Gerade kleine Teams profitieren von weniger manuellen Routinen und einem klaren Release-Prozess. Der Einstieg muss nicht komplex sein: Build und Tests automatisieren, dann Staging und erst später komplexere Deployments ergänzen.
„Automatisierung macht Releases gefährlicher.“
In der Regel ist das Gegenteil der Fall, wenn die Pipeline passende Prüfungen, Freigaben und ein erprobtes Rollback enthält. Gefährlich sind vor allem unklare, selten ausgeführte und manuelle Abläufe, also genau das, was eine Pipeline ersetzt.
„Wir releasen doch nur selten.“
Auch seltene Releases profitieren von einem dokumentierten, wiederholbaren Ablauf. Gerade weil dann die Routine fehlt, wiegt ein manueller Fehler umso schwerer.
Warum Pipelines, und nicht einfach KI direkt?
Diese Frage kommt zu Zeiten von Claude, Codex und Antigravity natürlich sofort auf und die Antwort ist kurz und einfach: Für die Ausführung braucht es Determinismus, aber für die Vorbereitung hilft KI durchaus.
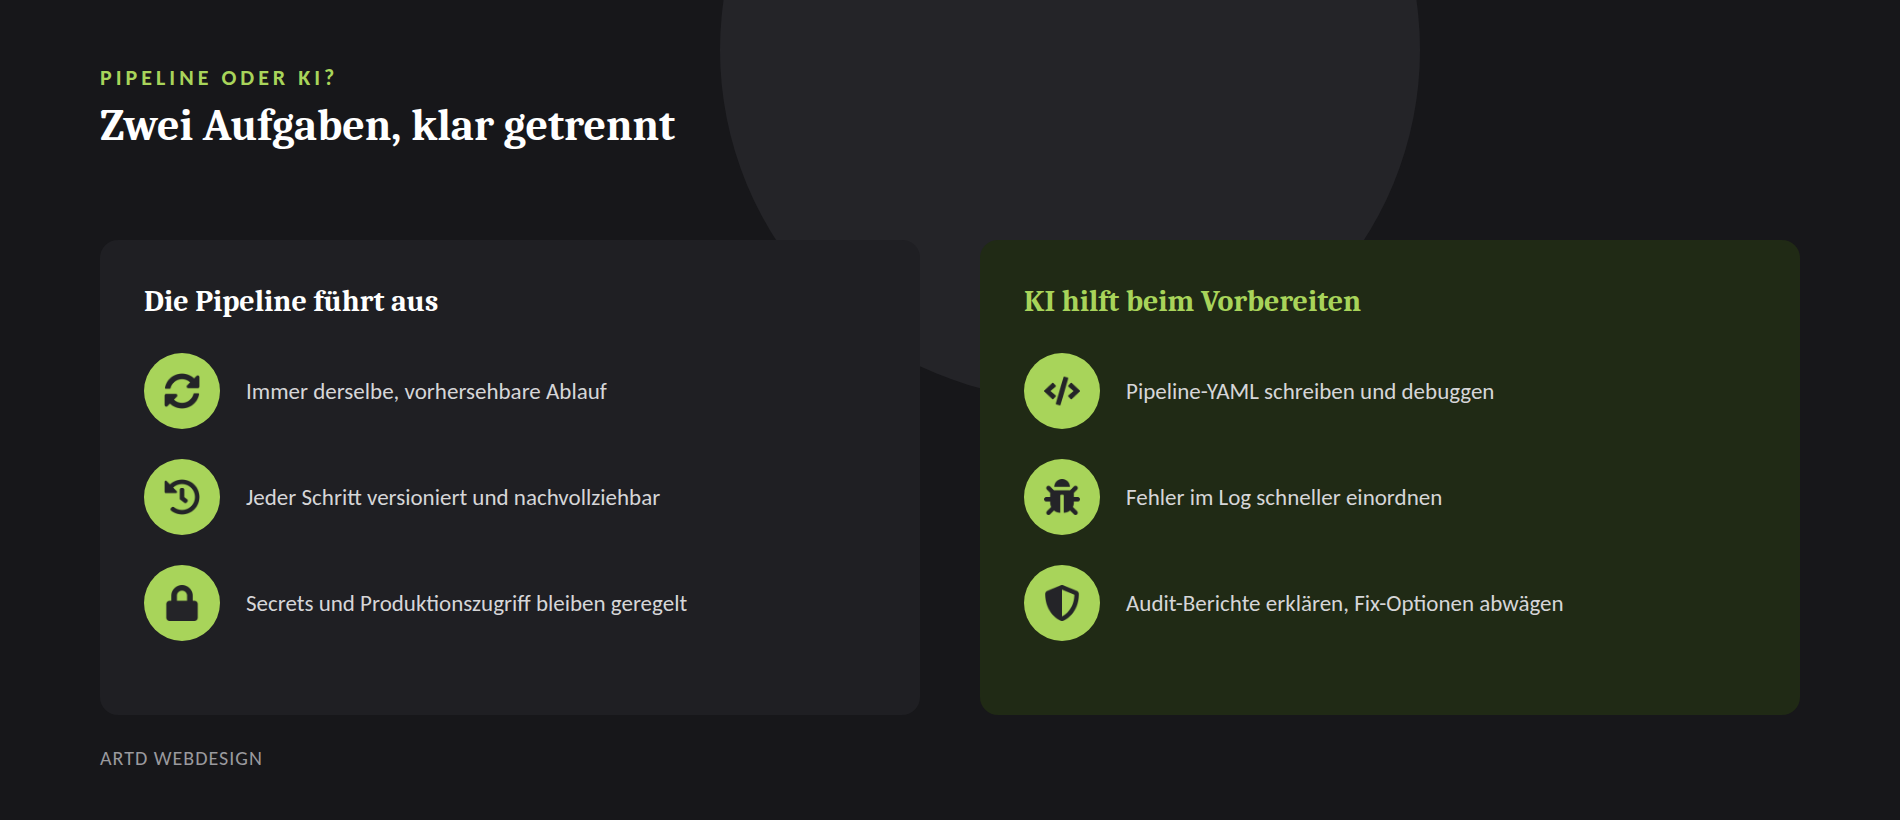
Eine Pipeline liefert bei derselben Eingabe denselben, vorhersehbaren Ablauf. Jeder Schritt, jede Regel und jedes Ergebnis ist versioniert und nachvollziehbar. Ein Sprachmodell arbeitet dagegen probabilistisch und liefert nicht bei jedem Lauf exakt dieselbe Antwort, für ein Deployment mit Produktionszugriff ist das der falsche Ansatz und sogar hoch riskant. Dazu kommt die Zugriffsfrage: Passwörter, API-Keys und Server-Zugänge sollten niemals in KI-Tools landen, ein Agent mit direktem Produktionszugriff ist daher ohnehin ausgeschlossen.
Beim Bauen der Pipeline selbst ist KI dagegen sehr wohl hilfreich: beim Schreiben und Debuggen der YAML-Syntax, beim Einordnen eines langen Fehlerlogs, oder beim Erklären eines composer audit-Berichts samt Abwägung der Fix-Optionen. Die Pipeline führt aus, KI unterstützt beim Verstehen und Vorbereiten.
Einstieg in fünf Schritten
- Aktuellen Release-Prozess sichtbar machen und manuelle Risiken sammeln.
- Versionskontrolle und einen verbindlichen Hauptbranch etablieren.
- Build sowie die wichtigsten automatischen Tests ausführen lassen.
- Staging-Umgebung und eine kurze Abnahme-Checkliste einrichten.
- Rollback testen, bevor der erste kritische Release ihn braucht.
Fazit
Eine Deployment Pipeline ist keine Selbstzweck-Automatisierung. Sie ist eine Investition in verlässliche Releases: weniger manuelle Fehler, schnelleres Feedback bei jeder Änderung, und ein Prozess, der sich jederzeit nachvollziehen lässt. Bei uns hat sich das über mehrere Statamic-Projekte hinweg bewährt, von der Qualitätsprüfung bei jedem Pull Request bis zum automatischen Dependency-Update.
Der grösste Effekt einer Deployment Pipeline zeigt sich nicht am Tag des Releases, sondern an all den Tagen davor, an denen nichts passiert: kein hektischer Fix kurz vor Feierabend, kein Rätselraten, welche Version gerade auf dem Server läuft.
Du willst wissen, wie eine Pipeline für euer eigenes Projekt aussehen könnte? Nimm unverbindlich Kontakt mit uns auf. Wir schauen uns eure aktuelle Release-Praxis gemeinsam an.
Häufige Fragen
Bei Continuous Integration werden Änderungen laufend zusammengeführt und automatisch geprüft. Bei Continuous Delivery ist eine geprüfte Version danach jederzeit bereit für die Veröffentlichung, der Release selbst bleibt aber eine bewusste, manuelle Entscheidung. Bei Continuous Deployment entfällt dieser letzte Schritt, jede erfolgreich geprüfte Änderung geht automatisch live.
Ja, gerade kleine Teams profitieren davon, weil weniger manuelle Routinen anfallen und der Release-Prozess klar bleibt. Der Einstieg muss nicht komplex sein: zuerst Build und Tests automatisieren, Staging und komplexere Deployments lassen sich später ergänzen.
Nein, bei den meisten unserer Projekte setzen wir auf Continuous Delivery. Tests und Build laufen bei jedem Push automatisch, das Deployment selbst bleibt an den main-Branch gebunden und damit eine bewusste Entscheidung.
Wir arbeiten mit vier eigenständigen Pipelines: Qualitätsprüfung bei jedem Push und Pull Request, Deployment nur auf main, ein wöchentliches Dependency-Update sowie ein tägliches Security Audit, das bei kritischen Funden automatisch das Dependency-Update anstösst.
Weil ein Deployment mit Produktionszugriff Determinismus braucht, ein Sprachmodell aber probabilistisch arbeitet und nicht bei jedem Lauf exakt dasselbe Ergebnis liefert. Dazu dürfen Passwörter, API-Keys und Server-Zugänge laut unserer eigenen KI-Policy ohnehin nicht in KI-Tools landen. Beim Schreiben und Debuggen der Pipeline selbst hilft uns KI dagegen sehr wohl.
Aktuell noch nicht flächendeckend. Eine feste Staging-Umgebung und kurzlebige Preview-Umgebungen pro Pull Request stehen bei uns für die nächsten Monate auf der Liste, im Moment prüfen wir Änderungen grösstenteils lokal und über den PR-Diff.
Das hängt vom eingesetzten Tool ab. Unser Bitbucket-Plan beinhaltet 2’500 Build-Minuten pro Monat, zusätzliche Minuten kosten 10 USD pro 1’000 Minuten. Für die meisten Projekte in unserer Grössenordnung reicht das gut aus.
In der Regel ist das Gegenteil der Fall, wenn die Pipeline passende Prüfungen, Freigaben und ein erprobtes Rollback enthält. Gefährlich sind vor allem unklare, selten ausgeführte und manuelle Abläufe, also genau das, was eine Pipeline ersetzt.


